ওভারফিটিং: মুখস্থবিদ্যার অভিশাপ
আমাদের শিক্ষাব্যবস্থার একটা পরিচিত চরিত্র আছে: যে ছাত্র গাইড বইয়ের প্রতিটা উত্তর দাঁড়ি-কমা সহ মুখস্থ করে। পরীক্ষায় হুবহু প্রশ্ন এলে সে ফাটিয়ে দেয়। কিন্তু শিক্ষক প্রশ্নটা একটু ঘুরিয়ে দিলে, একটা সংখ্যা বদলে দিলে, তার খাতা ফাঁকা।
মেশিন লার্নিংয়ে এই সমস্যার নাম ওভারফিটিং।
ওভারফিটিং কী
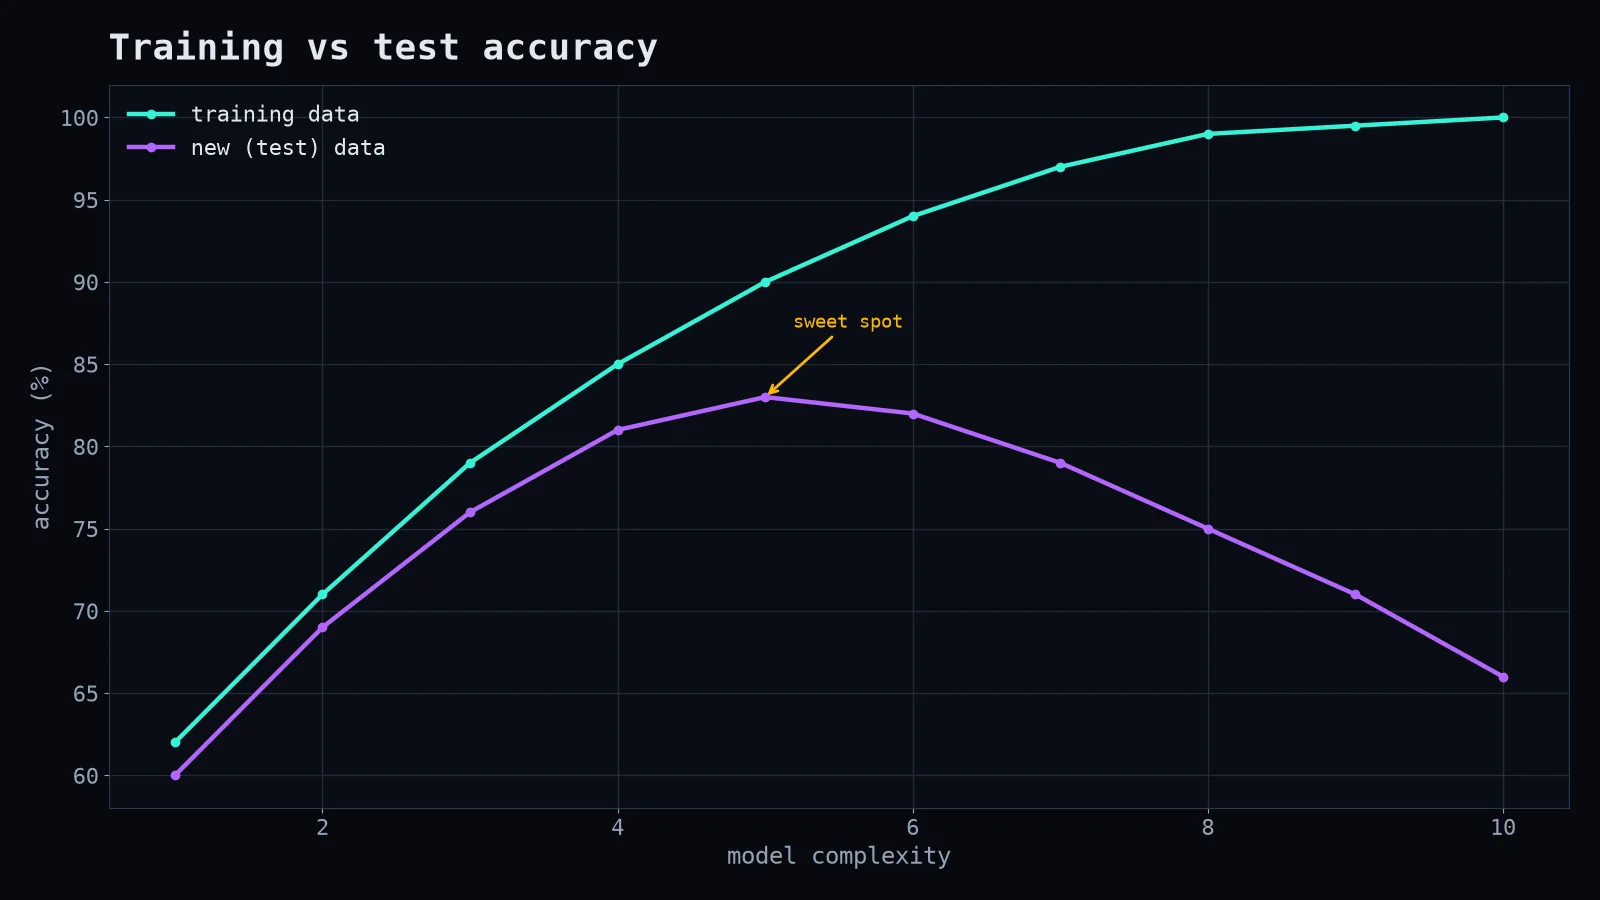
মডেল যখন প্রশিক্ষণের ডেটার আসল প্যাটার্ন শেখার বদলে প্রতিটা উদাহরণ, এমনকি ডেটার ভুল আর এলোমেলো অংশও, মুখস্থ করে ফেলে। প্রশিক্ষণের ডেটায় দারুণ ফল, নতুন ডেটায় খারাপ।
আর আসল জীবনে মডেলকে সবসময় নতুন ডেটাই সামলাতে হয়।
কীভাবে ধরবেন
ডেটাকে দুই ভাগ করুন। এক ভাগ দিয়ে শেখান, আরেক ভাগ (যেটা মডেল কখনো দেখেনি) দিয়ে পরীক্ষা নিন। ঠিক যেমন ভালো শিক্ষক গাইড বইয়ের বাইরের প্রশ্ন দিয়ে পরীক্ষা নেন।
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

gobhir_gach = DecisionTreeClassifier(max_depth=None).fit(X_train, y_train)   # সীমাহীন জটিল
shimito_gach = DecisionTreeClassifier(max_depth=4).fit(X_train, y_train)     # সংযত

for nam, m in [("গভীর", gobhir_gach), ("সংযত", shimito_gach)]:
    print(nam, m.score(X_train, y_train), m.score(X_test, y_test))
# গভীর গাছ: train 1.00, test 0.71  <- মুখস্থ!
# সংযত গাছ: train 0.86, test 0.83  <- বুঝেছে
প্রশিক্ষণে ১০০% আর পরীক্ষায় অনেক কম? সন্দেহ করুন: মুখস্থ হয়েছে, শেখা হয়নি।
কেন হয়
- ডেটা কম, মডেল খুব শক্তিশালী। একটা বিশাল মডেলকে পঞ্চাশটা উদাহরণ দিলে সে সহজেই সব মুখস্থ করে ফেলে।
- অনেক বেশি সময় প্রশিক্ষণ। একই প্রশ্ন বারবার পড়তে পড়তে উত্তর মুখস্থ।
- অপ্রয়োজনীয় ফিচার। রোল নম্বর দিয়ে পরীক্ষার ফল অনুমান করার মতো, যা কাকতালীয়ভাবে মিলে যেতে পারে।
সমাধান
বেশি ডেটা: যত বেশি ধরনের প্রশ্ন দেখবে, মুখস্থ করা তত কঠিন, বোঝা তত জরুরি।
সহজ মডেল: সবসময় সবচেয়ে জটিল মডেল দরকার না।
রেগুলারাইজেশন: মডেলকে জটিলতার জন্য "শাস্তি" দেওয়া, যাতে সে সহজ ব্যাখ্যা পছন্দ করে।
আর্লি স্টপিং: পরীক্ষার ফল উন্নতি থামলেই প্রশিক্ষণ বন্ধ।
ক্রস-ভ্যালিডেশন: একবার না, কয়েকবার ভিন্ন ভিন্ন ভাগে পরীক্ষা নেওয়া, যাতে ভাগ্যক্রমে ভালো ফল দেখে প্রতারিত না হন।
উল্টো সমস্যা: আন্ডারফিটিং
যে ছাত্র কিছুই পড়েনি, তার প্রশিক্ষণ আর পরীক্ষা দুটোতেই খারাপ ফল। মডেল খুব সহজ হলে প্যাটার্নই ধরতে পারে না। আসল দক্ষতা হলো মাঝামাঝি জায়গাটা খুঁজে পাওয়া।
শিক্ষাব্যবস্থার জন্যও একটা শিক্ষা
মজার ব্যাপার হলো, মেশিন লার্নিং গবেষকরা যে সমস্যা নিয়ে দশকের পর দশক কাজ করছেন, আমাদের শিক্ষাব্যবস্থাও সেই একই সমস্যায় ভোগে। মুখস্থ নির্ভর পরীক্ষা "ওভারফিটেড" ছাত্র তৈরি করে, যারা পরীক্ষায় ভালো কিন্তু নতুন সমস্যায় অসহায়। ভালো মডেল আর ভালো ছাত্র, দুটোরই লক্ষ্য একই: শুধু উত্তর না, পেছনের নিয়মটা বোঝা।