নিউরাল নেটওয়ার্ক: মাথার ভেতরের গল্প, সহজ ভাষায়
নানুর বাড়ির আম বাগানে একজন বৃদ্ধ মালি ছিলেন। দূর থেকে একটা আম দেখে বলে দিতেন পাকা না কাঁচা। কীভাবে? রং, আকার, গাছের কোন দিকে ঝুলছে, বছরের কোন সময়, সব মিলিয়ে তার মাথায় একটা হিসাব চলত। তিনি কোনো সূত্র মুখস্থ করেননি; বছরের পর বছর দেখে দেখে শিখেছিলেন।
নিউরাল নেটওয়ার্ক অনেকটা সেই মালির মতো শেখে।
ছোট ছোট সিদ্ধান্তের স্তর
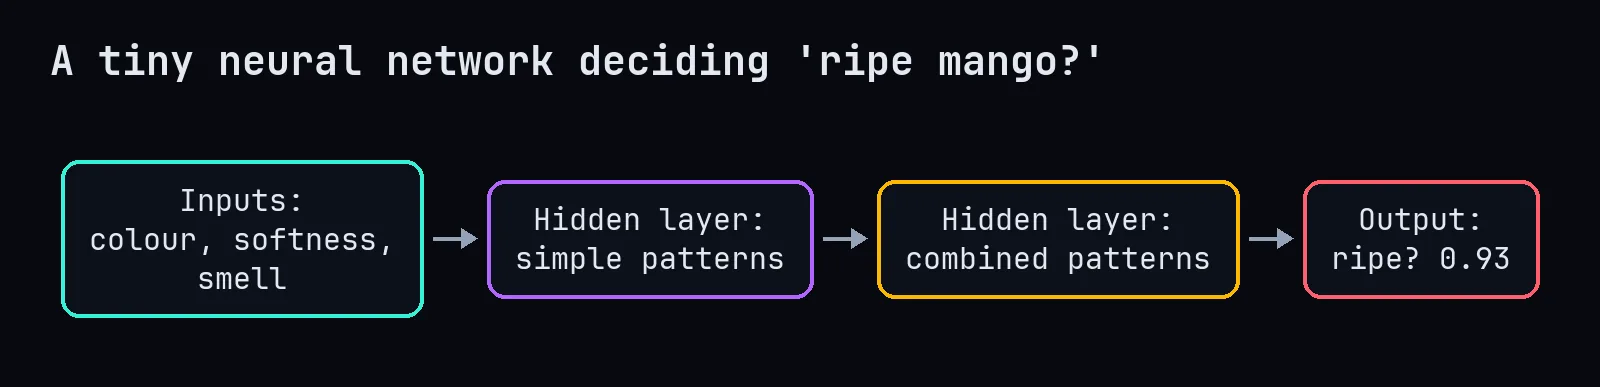
ইনপুট স্তর: আমের তথ্য: রং কতটা হলুদ, কতটা নরম, গন্ধ কতটা মিষ্টি।
লুকানো স্তর (hidden layers): প্রতিটা "নিউরন" ইনপুটগুলোকে আলাদা গুরুত্ব (weight) দিয়ে যোগ করে, তারপর ঠিক করে কতটা "সাড়া" দেবে। কোনো নিউরন হয়তো শেখে "হলুদ আর নরম একসাথে হলে গুরুত্বপূর্ণ"। পরের স্তর এগুলো মিলিয়ে আরও জটিল প্যাটার্ন ধরে।
আউটপুট স্তর: "এই আমটা পাকা হওয়ার সম্ভাবনা ৯৩%।"
শেখে কীভাবে
শুরুতে নেটওয়ার্কের সব গুরুত্ব (weight) এলোমেলো। তাই প্রথম দিকে সে আন্দাজে উত্তর দেয়, আর বেশিরভাগই ভুল।
তারপর আমরা তাকে হাজারো আমের উদাহরণ দেখাই, যেগুলোর সঠিক উত্তর জানা। প্রতিবার ভুল করলে হিসাব করা হয়: কোন weight কতটা বদলালে ভুল কমবে। এই পদ্ধতির নাম ব্যাকপ্রপাগেশন (backpropagation), আর ভুল কমানোর ধাপে ধাপে চলার নাম গ্রেডিয়েন্ট ডিসেন্ট।
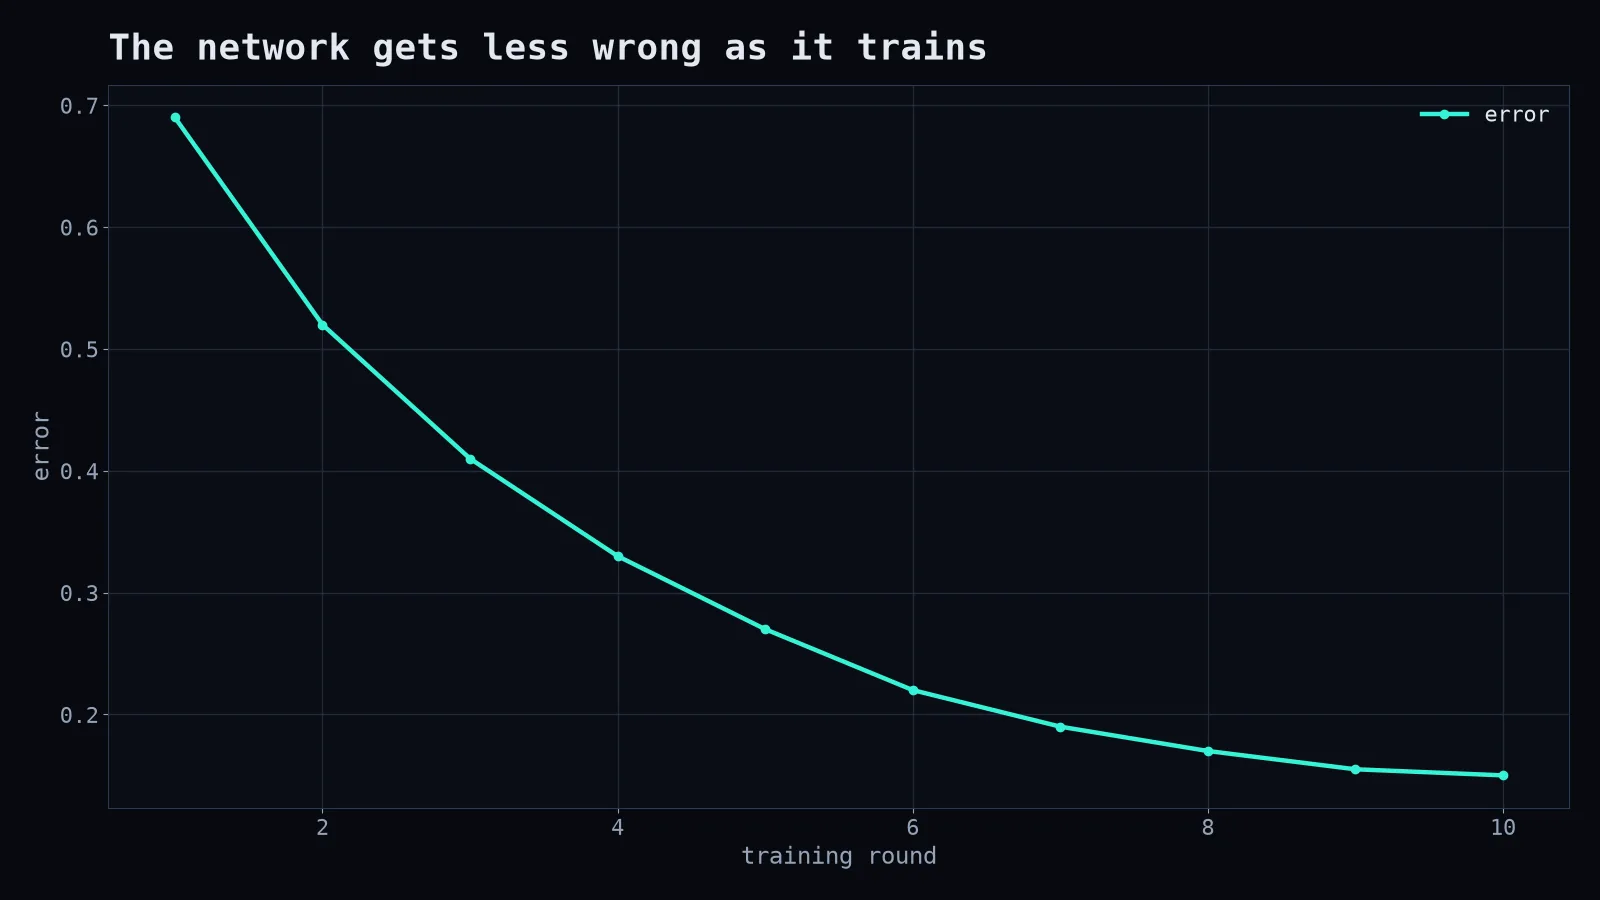
মালি যেমন প্রতিবার ভুল আন্দাজ করে আম কেটে দেখে নিজের ধারণা ঠিক করতেন, নেটওয়ার্কও তেমন।
ছোট্ট একটা কোড
from sklearn.neural_network import MLPClassifier

# [হলুদভাব, নরমভাব, মিষ্টি গন্ধ] -> পাকা (1) বা কাঁচা (0)
X = [[0.9, 0.8, 0.9], [0.2, 0.1, 0.1], [0.7, 0.6, 0.8], [0.3, 0.2, 0.3],
     [0.8, 0.9, 0.7], [0.1, 0.3, 0.2]]
y = [1, 0, 1, 0, 1, 0]

model = MLPClassifier(hidden_layer_sizes=(8, 4), max_iter=2000, random_state=1)
model.fit(X, y)
print(model.predict_proba([[0.85, 0.7, 0.8]]))   # পাকা হওয়ার সম্ভাবনা বেশি
বাস্তবে অবশ্য ছয়টা না, হাজার হাজার উদাহরণ লাগে।
"ডিপ" লার্নিং কেন ডিপ
অনেকগুলো লুকানো স্তর থাকলে তাকে বলে ডিপ নিউরাল নেটওয়ার্ক। ছবি চেনার নেটওয়ার্কে প্রথম স্তর হয়তো শেখে রেখা আর কোণা, পরের স্তর আকৃতি, তার পরের স্তর চোখ-নাক, আর শেষে পুরো মুখ। ChatGPT এর মতো ভাষা মডেলগুলোতে কোটি কোটি, এমনকি লাখো কোটি weight থাকে।
যা নিউরাল নেটওয়ার্ক না
- এটা মানুষের মস্তিষ্কের হুবহু নকল না। নামটা অনুপ্রেরণা থেকে, কাজের ধরন অনেক আলাদা।
- এটা "বোঝে" কি না, সেটা দার্শনিক বিতর্ক। কিন্তু এটা প্যাটার্ন চেনায় অসাধারণ।
- এটা নিজে থেকে ভুল স্বীকার করে না। যে ডেটায় শেখেনি, সেখানে আত্মবিশ্বাসের সাথে ভুল করতে পারে।
শেষ কথা
নানুর বাগানের মালি আর আধুনিক নিউরাল নেটওয়ার্কের মধ্যে মূল মিল একটাই: অনেক উদাহরণ দেখা, ভুল থেকে শেখা, আর ধীরে ধীরে নিজের "অনুমান" ঠিক করা। পার্থক্য হলো, মালির বছরের পর বছর লেগেছিল; কম্পিউটার কয়েক ঘণ্টায় লাখো আম দেখে ফেলে। তবে আম খাওয়ার আনন্দটা এখনো মানুষেরই।